

Hebbsches Lernen trifft Hopfield-Netze: Die Architektur, die schon immer klüger war als Transformer
Ein Jahrzehnt lang haben Transformer und ihre Attention-Mechanismen die KI-Landschaft dominiert. Von GPT über BERT bis zu den Vision Transformers: Das Mantra „Attention is all you need“ hat verändert, wie wir über maschinelles Lernen denken. Übersetzersysteme, also Encoder-Decoder-Pipelines, die Daten zwischen verschiedenen Repräsentationen umwandeln, wurden zum Rückgrat von allem, von der Sprachverarbeitung bis zur Bildgenerierung. Sie waren revolutionär. Sie waren leistungsstark.
Und jetzt stoßen sie an eine Wand.
Die Ironie dabei: Die Lösung gibt es seit 1982. In jenem Jahr veröffentlichte John Hopfield in den Proceedings of the National Academy of Sciences eine Arbeit, die ein rekurrentes neuronales Netz mit einer Eigenschaft vorstellte, die Transformer nie wirklich erreicht haben: garantierte Konvergenz zu stabilen Zuständen durch Energieminimierung. Das Hopfield-Netz lernte Muster nicht nur, es speicherte sie als physikalische Attraktoren in einer Energielandschaft, abrufbar selbst aus verrauschten oder unvollständigen Eingaben.
Die KI-Community beginnt erst jetzt zu begreifen, was Physik und Neurowissenschaft seit Jahrzehnten wissen: Der energiebasierte, assoziative Ansatz neuronaler Berechnung ist keine historische Kuriosität, sondern ein grundlegendes Paradigma, auf dem die Transformer-Ära lediglich aufgebaut hat, ohne es ganz zu verstehen.
Die Transformer-Decke
Transformer arbeiten, indem sie über Self-Attention die Beziehungen zwischen allen Elementen einer Sequenz gleichzeitig berechnen. Für Sprache ist das brillant. Für strukturierte Daten mit klaren sequenziellen Mustern ebenfalls. Doch die reale Welt, die Welt der Robotik, der eingebetteten Schaltungen, der sensorgesteuerten Entscheidungen und des Edge Computing, ordnet sich nicht in saubere Sequenzen, die darauf warten, beachtet zu werden.
Die Transformer-Architektur setzt Überfluss voraus: reichlich Rechenleistung, reichlich Speicher, reichlich Energie. Self-Attention skaliert quadratisch mit der Sequenzlänge. Feed-Forward-Schichten wachsen linear, aber gewaltig. Setzt man ein Transformer-basiertes System in einem mobilen Roboter ein, der durch ein Lager navigiert, oder bettet man es in eine elektronische Schaltung ein, die einen Fertigungsarm steuert, brechen diese Annahmen zusammen.
Das Übersetzer-Paradigma bringt zudem seine eigene Beschränkung mit: Es behandelt Intelligenz im Kern als Umwandlungsproblem zwischen festen Repräsentationen. Eingabe kodieren. Ausgabe dekodieren. Doch echte Intelligenz übersetzt nicht nur: Sie erinnert sich, sie assoziiert, und sie konvergiert zu stabilen Deutungen, selbst wenn die Eingabe verfälscht oder mehrdeutig ist.
Wir haben diese Probleme mit Quantisierung, Destillation, Pruning und hundert weiteren Optimierungstricks geflickt. Edge-AI-Übersichten aus dem Jahr 2025 bestätigen, dass der Einsatz von Deep Learning auf eingebetteter Hardware weiterhin „durch strikte Grenzen bei Speicher, Rechenleistung und Energie eingeschränkt“ bleibt. Doch die Optimierung einer grundsätzlich unpassenden Architektur verschiebt die Abrechnung nur. Wir brauchen eine Architektur, die Gedächtnis, Stabilität und Energieeffizienz als erste Prinzipien behandelt, nicht als nachträglichen Einfall.
Das Hopfield-Netz tritt auf
Ein Hopfield-Netz ist ein rekurrentes neuronales Netz aus einer einzigen Schicht von Neuronen, in der jedes Neuron mit jedem anderen Neuron verbunden ist, nur nicht mit sich selbst. Das Netz bildet einen vollständigen ungerichteten Graphen: Jedes Neuronenpaar teilt sich ein symmetrisches Verbindungsgewicht, das heißt, die Stärke von Neuron i zu Neuron j ist identisch mit der Stärke von jzu i. Es gibt keine Selbstverbindungen (wᵢᵢ = 0). Keine geschichtete Hierarchie. Keine sequenzielle Verarbeitungskette. Stattdessen arbeitet das gesamte Netzwerk als ein einziges, vollständig vernetztes dynamisches System, das sich im Lauf der Zeit auf stabile Gleichgewichtszustände zubewegt.
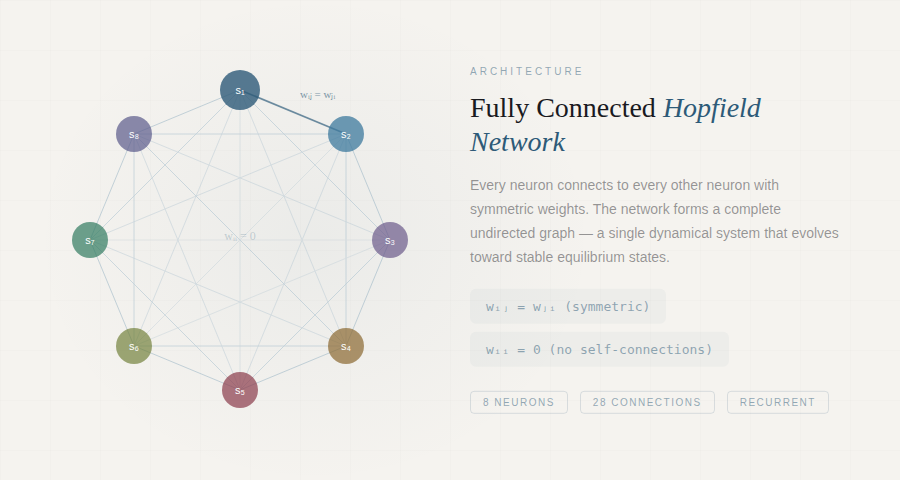
Ein Hopfield-Netz mit vollständig verbundenen Neuronen. Jeder Knoten ist mit jedem anderen über symmetrische Gewichte verbunden (wᵢⱼ = wⱼᵢ) und bildet so einen vollständigen ungerichteten Graphen. Selbstverbindungen gibt es nicht.
Die Eleganz dieser Architektur liegt in ihrer Energiefunktion. Hopfield bewies, dass sein Netzwerk eine zugehörige Lyapunov-Energiefunktion besitzt:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Diese Energie sinkt garantiert bei jeder Aktualisierung eines Neurons (oder bleibt gleich). Das Netzwerk konvergiert immer: Es schwingt nie endlos, divergiert nie und verfängt sich nie in unendlichen Rechenschleifen. Es kommt zur Ruhe. Bruck zeigte 1990, dass dieses Einschwingverhalten mit Schnitten im zugehörigen Graphen zusammenhängt: Bei jedem Aktualisierungsschritt führt das Netzwerk im Grunde einen Greedy-Algorithmus für das Max-Cut-Problem aus.
Und dort, wo das Netzwerk zur Ruhe kommt, steckt die Intelligenz. Gespeicherte Muster entsprechen lokalen Minima der Energiefunktion, den Tälern in der Energielandschaft. Gibt man dem Netzwerk eine verfälschte, verrauschte oder unvollständige Version eines gespeicherten Musters vor, rollt die Dynamik den Netzwerkzustand bergab, bis er im nächstgelegenen Tal landet: dem gespeicherten Muster, das am besten zur Eingabe passt.

Die Energielandschaft eines Hopfield-Netzwerks. Jedes Tal (lokales Minimum) entspricht einem gespeicherten Erinnerungsmuster. Von jedem beliebigen Anfangszustand aus rollt die Netzwerkdynamik „bergab“, bis sie im nächstgelegenen Attraktor zur Ruhe kommt und so das vollständige Muster aus einer teilweisen oder verrauschten Eingabe rekonstruiert.
Das ist inhaltsadressierbarer assoziativer Speicher die Fähigkeit, vollständige Erinnerungen aus bruchstückhaften Hinweisen abzurufen. Biologische Gehirne tun das mühelos, Transformer können es nur mit aufwendiger Rechenarbeit annähern.
Die Verbindung zur Physik reicht tief. Das Hopfield-Netzwerk ist mathematisch äquivalent zu einem Ising-Modell, also genau dem Rahmenwerk, mit dem die statistische Mechanik den Magnetismus beschreibt. Das 1975 veröffentlichte Sherrington-Kirkpatrick-Modell des Spinglases ist im Wesentlichen ein Hopfield-Netzwerk mit zufälligen Gewichten. Hopfields Einsicht bestand darin, diese Eigenschaft gezielt auszunutzen und die Energielandschaft so zu gestalten, dass jedes Minimum einem nützlichen gespeicherten Muster entspricht.
Hebbsches Lernen: Neuronen, die gemeinsam feuern, verdrahten sich miteinander
Die Lernregel, die Hopfield-Netzwerke funktionieren lässt, hat Wurzeln, die noch weiter zurückreichen, nämlich bis zu Donald Hebbs Buch von 1949, The Organization of Behavior, das heute als Gründungsprinzip der neuronalen Lerntheorie gilt.
Hebbs Einsicht war täuschend einfach: Wenn eine präsynaptische Zelle wiederholt und anhaltend daran beteiligt ist, eine postsynaptische Zelle zum Feuern zu bringen, verstärkt sich die synaptische Verbindung zwischen beiden. „Neurons that fire together, wire together“, auch wenn Hebb selbst präziser war und betonte, dass Zelle A daran beteiligt sein muss, zu bewirken, dass Zelle B feuert, und nicht bloß zur selben Zeit zu feuern. Diese zeitliche Kausalität nahm vorweg, was heute als spike-timing-abhängige Plastizität (STDP) bekannt ist und Jahrzehnte später experimentell bestätigt wurde, unter anderem durch Eric Kandels bahnbrechende Forschung an der Meeresschnecke Aplysia californica.
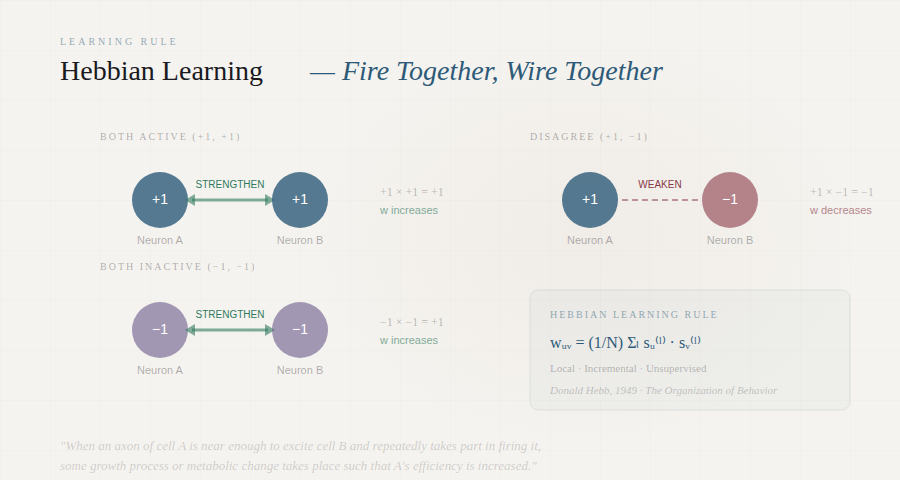
Hebbsches Lernen: Wenn zwei verbundene Neuronen wiederholt gemeinsam aktiv sind, verstärkt sich die Synapse zwischen ihnen. Dieses Prinzip, „Neuronen, die gemeinsam feuern, verdrahten sich miteinander“, ist das biologische Fundament dafür, wie Hopfield-Netze Muster speichern.
Im Hopfield-Netz wird das Hebbsche Lernen so umgesetzt:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) für alle gespeicherten Muster l, wobei u ≠ v
Haben zwei Neuronen in einem Muster denselben Zustand (beide +1 oder beide −1), ist ihr Produkt positiv und die erregende Verbindung wird gestärkt. Unterscheiden sie sich, ist das Produkt negativ und es entsteht eine hemmende Verbindung. In der Summe formt sich so eine Energielandschaft, die an jedem gespeicherten Muster ein Tal hat.
Die Hebbsche Regel ist lokal (jede Gewichtsanpassung braucht nur Informationen, die den beiden verbundenen Neuronen zur Verfügung stehen) und inkrementell (neue Muster lassen sich speichern, ohne die alten erneut zu verarbeiten). Bemerkenswerterweise lässt sich mathematisch zeigen, dass das Hebbsche Lernen eine unüberwachte Hauptkomponentenanalyse (PCA) der Eingabedaten durchführt: Das Netz extrahiert von sich aus die statistisch bedeutsamsten Merkmale aus seiner Umgebung.
1997 stellte Amos Storkey eine verbesserte Lernregel vor, die das lokale Feld an jedem Neuron berücksichtigt und dadurch eine größere Speicherkapazität erreicht als das übliche Hebbsche Lernen. Das zeigt, dass selbst innerhalb derselben Architektur die Wahl des Lernalgorithmus tiefgreifend zählt, ein Prinzip, das zur größeren Lehre der Forschung an neuronalen Netzen passt.
Der Durchbruch: „Hopfield Networks is All You Need“
2020 veröffentlichte ein Team um Hubert Ramsauer an der Johannes Kepler Universität Linz eine Arbeit mit einem provokanten Titel, der an die Entstehungsgeschichte des Transformers erinnert: „Hopfield Networks is All You Need“. Ihr Beitrag war der mathematische Beweis für etwas, das viele schon vermutet hatten: Der Self-Attention-Mechanismus in Transformern ist genau die Update-Regel eines modernen kontinuierlichen Hopfield-Netzes.

Die Verbindung zwischen modernen Hopfield-Netzen und der Attention in Transformern. Der Softmax-basierte Attention-Mechanismus in Transformern ist mathematisch äquivalent zu einem Update-Schritt eines kontinuierlichen Hopfield-Netzes mit exponentieller Energiefunktion. Bild aus Ramsauer et al., „Hopfield Networks is All You Need“.
Das war nicht bloß eine Analogie. Das Team zeigte: Verallgemeinert man die klassische Hopfield-Energiefunktion auf kontinuierliche Zustände und verwendet einen exponentiellen Wechselwirkungsterm, lautet die resultierende Update-Regel:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
und das ist genau die Attention-Formel des Transformers. Das moderne Hopfield-Netz kann exponentiell viele Muster speichern (in Abhängigkeit von der Dimension des assoziativen Raums), ruft sie in einem einzigen Update ab und hat exponentiell kleine Abruffehler.
Die Arbeit identifizierte in diesem modernen Rahmen drei Arten von Energieminima: (1) einen globalen Fixpunkt, der über alle gespeicherten Muster mittelt, (2) metastabile Zustände, die über Teilmengen von Mustern mitteln, und (3) Fixpunkte, die einzelne Muster speichern. Transformer-Köpfe in den unteren Schichten arbeiten tendenziell im Regime der globalen Mittelung, während Köpfe in höheren Schichten metastabile Zustände nutzen, um Informationen zu sammeln und zu verarbeiten, eine Erkenntnis, die tiefe Einblicke darin gibt, warum Transformer so funktionieren, wie sie funktionieren.
Die praktische Folge war unmittelbar: Das Team veröffentlichte Hopfield-Schichten als Drop-in-PyTorch-Module, die Pooling-Schichten, GRU-/LSTM-Schichten und Standard-Attention-Schichten ersetzen könnten. In Benchmarks erzielten diese Hopfield-Schichten Spitzenergebnisse bei der Klassifikation von Immunrepertoires (mit mehreren hunderttausend Instanzen pro Probe), bei Multiple-Instance-Learning-Problemen und bei UCI-Klassifikations-Benchmarks, an denen klassische Deep-Learning-Methoden üblicherweise scheitern.
Im Dezember 2025 ging ein NeurIPS-Paper von Masumura und Taki noch weiter: Es zeigte, dass der Blick über die „adiabatische Näherung“ hinaus verborgene Zustände in der Entsprechung von Hopfield-Netzen und Transformern offenlegt. Sie können das Rangkollaps- und das Token-Uniformitätsproblem tiefer Transformer lösen und die Genauigkeit verbessern, ohne einen einzigen zusätzlichen Trainingsparameter hinzuzufügen.
Der wachsende Konsens: Wer sagt das noch?
Die These, dass Hopfield-Netze das nächste Paradigma nach den Transformern darstellen, ist keine Spekulation. Große Forschungseinrichtungen verfolgen sie aktiv, und die Belege häufen sich schnell. Hier sind die wichtigsten Stimmen und Arbeiten, die zum selben Schluss kommen.
IBM Research und Dmitry Krotov
Im Januar 2025 veröffentlichte IBM Research ein ausführliches Interview mit Dmitry Krotov, Hopfields langjährigem Mitstreiter und einem der Architekten des Dense Associative Memory. Krotov argumentierte klar: Da Hopfield-Netze die rekurrenten Rückkopplungsschleifen des Gehirns abbilden, anders als die Feedforward-Architektur von 90 % der heutigen KI-Modelle, seien sie „eine vielversprechende Alternative zu den heutigen Feedforward-Netzen“. Er wies darauf hin, dass Transformer Informationen nur in eine Richtung verarbeiten und die Rechenkomplexität rasch steigt, wenn die Kontextfenster länger werden. Das Gehirn dagegen nutzt rekurrente Rückkopplungsschleifen, um vergangene Informationen zusammenzufassen und im Gedächtnis zu speichern. Hopfield-Netze funktionieren genauso.
Krotov beschrieb außerdem den Energy Transformer (NeurIPS 2023), eine Zusammenarbeit von IBM Research und Georgia Tech. Er legt Erkenntnisse aus der Hopfield-Forschung nicht bloß als Schicht über bestehende Transformer, sondern ersetzt die gesamte Folge von Feedforward-Transformer-Blöcken durch ein einziges großes Assoziativspeicher-Modell. Der Attention-Mechanismus im Energy Transformer unterscheidet sich ausdrücklich von der herkömmlichen Attention: Er wird aus den Grundprinzipien der Energieminimierung abgeleitet und nicht nachträglich an eine Feedforward-Pipeline angeflanscht.
🔗 IBM Research: „Searching for brain-inspired AI algorithms“ (Jan. 2025)
🔗 Energy Transformer, arXiv:2302.07253 (NeurIPS 2023)
Johannes Kepler Universität – Hochreiters Gruppe
Sepp Hochreiter, Miterfinder des LSTM, leitete das Team, das „Hopfield Networks is All You Need“ veröffentlichte. Ihr Hopfield-Layers-Repository bietet praxistaugliche PyTorch-Module, die sich als Drop-in-Ersatz für Transformer-Attention-Schichten, Pooling-Schichten und rekurrente Schichten einsetzen lassen. Der begleitende Blogbeitrag leitet mathematisch her, dass die Softmax-Attention-Formel ein Spezialfall der modernen Hopfield-Update-Regel ist und dass Hopfield-Schichten zusätzliche Funktionen bieten, die Standard-Attention nicht leisten kann, darunter statische gelernte Prototypen und flexible Konfigurationen des Assoziativspeichers.
🔗 Hopfield Networks is All You Need – ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
Die jüngsten Belege stammen aus dem NeurIPS-Paper von Masumura und Taki vom Dezember 2025. Darin zeigten sie, dass Modern Hopfield Attention (MHA), die verborgene Zustände aus der vollständigen (nicht-adiabatischen) Hopfield-Dynamik ableitet, verbessert systematisch sowohl GPT-2- und LLaMA-Sprachmodelle als auch Vision Transformer. Die Verbesserungen kamen ohne zusätzliche Trainingsparameter aus. Noch wichtiger: MHA löst nachweislich das Problem des Rangkollapses (bei dem Aufmerksamkeitsmatrizen in tiefen Transformern degenerieren, sodass alle Token zu ähnlichen Repräsentationen konvergieren), eine grundlegende Pathologie, die die Skalierung von Transformern seit jeher plagt. Die Autoren schließen: „Wir hoffen, dass diese Forschung neue Möglichkeiten für den systematischen Entwurf von Transformer-Architekturen mit Hopfield-Netzwerken eröffnet.“
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: Biologisch plausibles Online-Lernen
Im Mai 2024 veröffentlichte Nature Communications eine Arbeit über das Sparse Quantized Hopfield Network, ein Modell, das mit lokalen Lernregeln in Online-Continual-Szenarien lernt, genau so, wie es biologische Gehirne tun. Damit wird eine grundlegende Einschränkung von Transformern angegangen, die nicht-lokale Backpropagation und Offline-Training auf kuratierten Datensätzen benötigen. Die Arbeit sieht Architekturen auf Hopfield-Basis als natürliche Brücke zwischen künstlichen neuronalen Netzen und neuromorpher Hardware.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Ausreißereffiziente Hopfield-Schichten für große Foundation-Modelle
Eine Arbeit von 2024 widmete sich einem praktischen Problem großer Transformer-Modelle: der Neigung, Aufmerksamkeit auf nichtssagende Token (Trennzeichen, Satzzeichen) zu verteilen, dem Problem der „No-Op-Ausreißer“. Ihre Lösung war eine ausreißereffiziente Hopfield-Energiefunktion, die diese Token klassifiziert und auf einen Punkt mit Nullenergie lenkt, sodass sie die nützliche Aufmerksamkeit nicht verwässern. Das resultierende Modell umfasst die Softmax₁-Attention als Spezialfall und wurde an BERT, OPT und Vision Transformern validiert. Das ist Hopfield-Theorie, die echte Probleme der Transformer-Entwicklung löst.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Transformer als Energieminimierer (Januar 2026)
Die jüngste theoretische Arbeit, veröffentlicht im Januar 2026, beschreibt den gesamten Forward-Pass eines Transformers als intrinsische Energieminimierung und übernimmt damit die Hopfield-Perspektive vollständig als Erklärungsrahmen dafür, warum Transformer überhaupt funktionieren. Die Arbeit verbindet sparse moderne Hopfield-Modelle mit der gesamten Familie der Attention-Varianten (Softmax, Sparsemax, α-Entmax) und zeigt, dass sie allesamt Spezialfälle einer energiebasierten Abrufdynamik sind.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (Jan. 2026)
Übersichtsarbeiten und Community-Ressourcen
Die breitere Forschungsgemeinschaft organisiert sich rund um diese Annäherung:
- „Energy-Based Learning and the Evolution of Hopfield Networks“ (TechRxiv, April 2025) Ein umfassender Überblick, der den ganzen Bogen von Hopfield (1982) über Boltzmann-Maschinen bis zur Neudeutung der Transformer-Attention als moderne Hopfield-Dynamik nachzeichnet. → Zur Arbeit
- „An Energy-Based Perspective on Attention Mechanisms in Transformers“ Ein ausführlicher technischer Blogbeitrag, der argumentiert, dass das Verständnis von Transformern durch die Hopfield-Energiebrille „zu qualitativ anderen Verbesserungen führen könnte, die über das hinausgehen, was allein durch Skalierung und Senkung der Rechenkomplexität möglich ist“. → Den Blog lesen
- Awesome Modern Hopfield Networks Ein kuratiertes GitHub-Repository, das über 50 Paper zu modernen Hopfield-Netzwerken aus ganz unterschiedlichen Bereichen verfolgt: Asset Allocation, Change Detection, Rekonstruktion kreativer Gedanken, Out-of-Distribution-Erkennung, Klassifizierung von Immunrepertoires und mehr. → Die Sammlung durchstöbern
- „Is Hopfield Networks All You Need?“ (Analytics India Magazine, Dez. 2024) Praxisnaher Bericht darüber, wie Hochreiters Team gezeigt hat, dass Hopfield-Netzwerke „austauschbar mit modernsten Transformer-Modellen“ sind. → Den Artikel lesen
- „New Research in Hopfield Networks: A Short Intro“ (Medium, Juli 2024) Verständlicher Überblick, der festhält, dass die Speicherkapazität durch exponentielle Aktivierungsfunktionen von 0,138N auf 2^(N/2) gewachsen ist. → Auf Medium lesen
Die Richtung ist eindeutig. Das ist weder der Vorschlag eines einzelnen Labors noch die Spekulation eines einzelnen Papers. IBM Research, die Johannes Kepler Universität, das MIT, NeurIPS, Nature Communications und die breitere Machine-Learning-Community kommen aus unterschiedlichen Richtungen zum selben Schluss: Das energiebasierte Paradigma des assoziativen Gedächtnisses, das Hopfield begründet hat, ist nicht nur das Fundament, auf dem Transformer unwissentlich gebaut wurden – es ist das Gerüst, das die KI über das hinausträgt, was Transformer allein leisten können.
Warum das jetzt wichtig ist: Gründe für den Wechsel
Garantierte Konvergenz für sicherheitskritische Systeme
Transformer liefern Ausgaben, aber es gibt keine mathematische Garantie für Stabilität. Hopfield-Netzwerke konvergieren nachweislich zu stabilen Zuständen – die Energiefunktion nimmt monoton ab. Für Robotik, autonome Fahrzeuge, Medizingeräte und jedes System, bei dem Zuverlässigkeit nicht verhandelbar ist, ist das eine Anforderung, die Transformer nicht erfüllen können.
Assoziatives Gedächtnis als Kernfähigkeit
Trainiert man ein Hopfield-Netzwerk so, dass der Zustand (1, −1, 1, −1, 1) ein Energieminimum ist, und gibt dann die gestörte Eingabe (1, −1, −1, −1, 1) vor, konvergiert das Netzwerk zum korrekten gespeicherten Muster. Es rät nicht und interpoliert nicht – es rollt in der Energielandschaft bergab zum nächsten Attraktor. Für Robotik mit verdeckten Sensoren, eingebettete Systeme mit verrauschten Daten und jede Anwendung, die Muster aus unvollständigen Eingaben ergänzen muss, ist das ein Durchbruch.
Eine universelle Optimierungsmaschine
Hopfield und David Tank zeigten 1985, dass sich mit Hopfield-Netzwerken das Problem des Handlungsreisenden lösen lässt. Lässt sich eine Kostenfunktion in der Form der Hopfield-Energie schreiben, dann sind die Gleichgewichtspunkte des Netzwerks die Lösungen. Seitdem wurde die Architektur auf Job-Shop-Scheduling, Kanalzuweisung in Funknetzen, Bildrestaurierung, Analog-Digital-Wandlung, mobiles Routing und kombinatorische Optimierung angewendet. Ein Paper in Nature Communications von 2024 stellte ein Sparse Quantized Hopfield Network vor, das online und kontinuierlich lernt und dabei lokale Regeln nutzt, ganz so wie biologische Gehirne – eine Fähigkeit, die Transformern grundsätzlich fehlt.
Hardware, die ohne Software denkt
Die Bedingung symmetrischer Gewichte (wᵢⱼ = wⱼᵢ) lässt sich direkt auf analoge elektronische Schaltungen abbilden – eine Widerstandsverbindung ist von Natur aus symmetrisch. Hopfield-Netzwerke lassen sich als ASICs oder FPGAs fertigen, mit Inferenz im Nanosekundenbereich. Die Nature-Sammlung von 2025 zum neuromorphen Computing bestätigt diese Richtung: energieeffiziente analoge Hardware, die neuronale Dynamik direkt am Edge umsetzt, mit inhaltsadressierbarem Speicher, der weder GPU noch CPU noch einen Software-Stack braucht.
Neuromorphe und analoge KI-Chips, die die Dynamik neuronaler Netze direkt in Hardware umsetzen. Die symmetrische, energiebasierte Struktur von Hopfield-Netzen lässt sich ganz natürlich auf Widerstandsschaltungen abbilden und ermöglicht KI-Inferenz im Nanosekundenbereich, ganz ohne klassische Software-Stacks.
Flexibel zwischen binär und kontinuierlich
Klassische Hopfield-Netze arbeiten mit binären Neuronen (+1 oder −1); kontinuierliche Varianten nutzen sigmoide Aktivierungsfunktionen und Differenzialgleichungen. Die Aktualisierung kann asynchron (ein Neuron nach dem anderen, was die Konvergenz garantiert) oder synchron (alle auf einmal, was Parallelität ermöglicht) erfolgen. Dieselbe Architektur passt sich an: vom Mikrocontroller mit wenigen Kilobyte RAM über den massiv parallelen FPGA bis hin zu GPU-beschleunigten Deep-Learning-Pipelines, jetzt mit modernen Hopfield-Schichten.
Speicherkapazität: Die ehrliche Grenze
Die klassische Einschränkung ist klar: Ein Netz aus N Neuronen speichert zuverlässig etwa 0,138N Muster, bevor Fehlzustände den Abruf verschlechtern. Das ist eine echte Grenze, aber eine ehrliche. Bei Transformern gibt es keine saubere mathematische Schranke dafür, ab wann sie zu halluzinieren beginnen.
Hinzu kommt: Moderne Hopfield-Netze (Krotov & Hopfield, 2016; Demircigil et al., 2017) erreichen durch Wechselwirkungsterme höherer Ordnung eine exponentielle Speicherkapazität. Die Forschung verschiebt diese Grenzen weiter: Sparse und strukturierte Hopfield-Netze, Hopfield-Gedächtnis für lange Sequenzen und Hopfield-Netze für die Vermögensallokation sind allesamt aktive Entwicklungsfelder, und die Zahl der Veröffentlichungen wächst rasant.
Praktischer Einsatz: Vom PC bis zur Schaltung
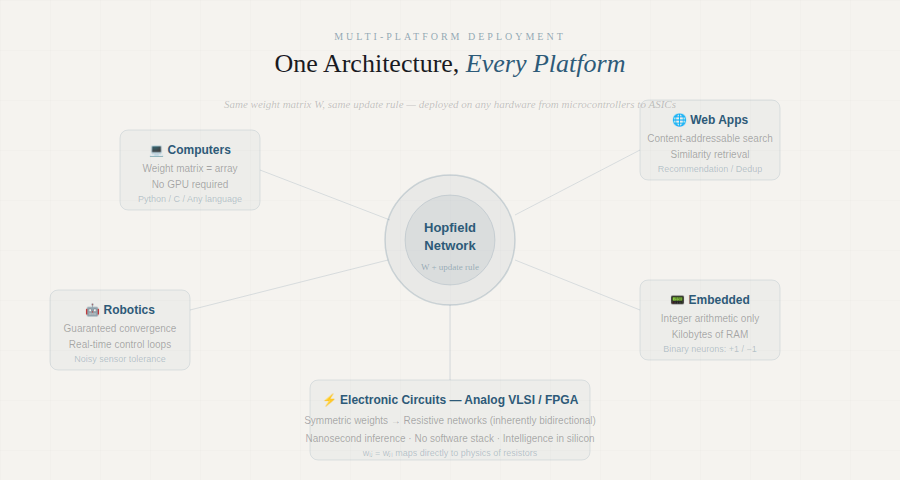
Die ursprüngliche Vision der frühen Forscher neuronaler Netze war klar: ein Rahmenwerk, das man einmal beschreibt und überall einsetzen kann. Hopfields Architektur löst dieses Versprechen ein:
Computeranwendungen Eine Gewichtsmatrix und eine Update-Regel. Keine GPU nötig.
Internetanwendungen Inhaltsadressierbarer Speicher für Ähnlichkeitssuche, Empfehlungen und Deduplizierung.
Robotik Garantierte Konvergenz für Echtzeit-Regelkreise. Bewegungsmuster werden als Attraktoren gespeichert und lassen sich selbst aus verrauschten Sensordaten abrufen.
Eingebettete Systeme Binäre Hopfield-Netze laufen auf Mikrocontrollern allein mit Ganzzahlarithmetik.
Elektronische Schaltungen Symmetrische Gewichte lassen sich auf Widerstandsnetzwerke abbilden. Intelligenz, direkt im Silizium gefertigt.
Der Weg nach vorn
Die Transformer-Ära hat uns außergewöhnliche Sprachmaschinen geschenkt. Doch die Grenze verschiebt sich in die physische Welt: Roboter, Sensoren, Aktoren und Entscheidungen in Echtzeit. Diese Grenze verlangt Architekturen, die stabil, effizient, interpretierbar und auf Hardware einsetzbar sind, die am Edge tatsächlich existiert.
Der Beweis von 2020, dass die Transformer-Attention eine moderne Hopfield-Update-Regel ist, war nicht bloß eine mathematische Kuriosität. Er zeigte, dass wir die ganze Zeit Hopfield-Netze benutzt haben, verpackt in ein Rahmenwerk, das ihr wahres Wesen verdeckte. Die NeurIPS-Arbeit von 2025, die zeigt, dass Hopfield-Hidden-States Transformer-Pathologien wie den Rangkollaps beheben, legt den nächsten Schritt nahe: Transformer nicht mit Hopfield-Erkenntnissen flicken, sondern direkt auf dem Hopfield-Paradigma selbst aufbauen.
John Hopfield hat uns 1982 den Weg gezeigt. Donald Hebb legte 1949 die biologischen Grundlagen. Jetzt steuert die Forschungsgemeinschaft darauf zu.
Zeit für den Wechsel.
Quellen
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of BehaviorWiley.
- Ramsauer, H. et al. (2020). „Hopfield Networks is All You Need.“ ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). „Dense Associative Memory for Pattern Recognition.“ NeurIPS.
- Storkey, A. (1997). „Increasing the capacity of a Hopfield network without sacrificing functionality.“ ICANN.
- Hoover, B., Krotov, D. et al. (2023). „Energy Transformer.“ NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). „On the Role of Hidden States of Modern Hopfield Network in Transformer.“ NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). „A sparse quantized Hopfield network for online-continual memory.“ Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). „Outlier-Efficient Hopfield Layers for Large Transformer-Based Models.“ arXiv:2404.03828
- Hu, J.Y. et al. (2026). „Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle.“ arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). „'Neural' Computation of Decisions in Optimization Problems.“ Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). „On the convergence properties of the Hopfield model.“ Proceedings of the IEEE.
- Krotov, D. (2025). „Searching for brain-inspired AI algorithms.“ IBM Research Blog. research.ibm.com
- „Energy-Based Learning and the Evolution of Hopfield Networks.“ TechRxiv, April 2025. techrxiv.org

