

Aprendizaxe hebbiana e redes de Hopfield: a arquitectura que sempre foi máis intelixenteca os transformers
Durante a última década, os transformers e os seus mecanismos de atención dominaron o panorama da IA. De GPT a BERT e aos Vision Transformers, o lema «attention is all you need» cambiou a nosa forma de pensar a aprendizaxe automática. Os sistemas tradutores, esas canalizacións codificador-decodificador que converten datos dunha representación a outra, pasaron a ser a columna vertebral de todo, desde o procesamento da linguaxe ata a xeración de imaxes. Foron revolucionarios. Foron potentes.
E agora estanse chocando contra un muro.
A ironía é que a solución existe desde 1982. Ese ano, John Hopfield publicou un artigo en Proceedings of the National Academy of Sciences no que presentaba unha rede neuronal recorrente cunha propiedade que os transformers nunca chegaron a acadar de verdade: a converxencia garantida cara a estados estables mediante a minimización da enerxía. A rede de Hopfield non só aprendía patróns: gardábaos como atractores físicos nunha paisaxe de enerxía, recuperables mesmo a partir de entradas ruidosas ou incompletas.
A comunidade da IA só agora empeza a interiorizar o que as comunidades da física e da neurociencia levan décadas sabendo: o enfoque asociativo e baseado na enerxía para a computación neuronal non é unha curiosidade histórica, senón un paradigma fundacional sobre o que a era dos transformers construíu sen chegar a comprendelo do todo.
O teito dos transformers
Os transformers funcionan calculando, mediante a autoatención, as relacións entre todos os elementos dunha secuencia á vez. Iso é brillante para a linguaxe. É brillante para datos estruturados con patróns secuenciais claros. Pero o mundo real, o da robótica, dos circuítos embebidos, da toma de decisións guiada por sensores e da computación na periferia (edge computing), non se organiza en secuencias ordenadas á espera de que alguén lles preste atención.
A arquitectura transformer dá por suposta a abundancia: abundancia de cómputo, de memoria, de enerxía. A autoatención escala de forma cuadrática coa lonxitude da secuencia. As capas feed-forward medran de forma lineal, pero masiva. Cando despregas un sistema baseado en transformers nun robot móbil que se move por un almacén, ou o integras nun circuíto electrónico que controla un brazo de fabricación, eses supostos veñen abaixo.
O paradigma do tradutor leva a súa propia limitación: trata a intelixencia sobre todo como un problema de conversión entre representacións fixas. Codificar a entrada. Decodificar a saída. Pero a intelixencia real non só traduce: recorda, asocia e converxe cara a interpretacións estables mesmo cando a entrada está degradada ou é ambigua.
Levamos tempo parcheando estes problemas con cuantización, destilación, poda e cen trucos de optimización máis. As revisións sobre Edge AI de 2025 confirman que despregar aprendizaxe profunda en hardware embebido segue «limitado por estritas restricións de memoria, cómputo e enerxía». Pero optimizar unha arquitectura fundamentalmente inadecuada só aprraza o axuste de contas. O que necesitamos é unha arquitectura que trate a memoria, a estabilidade e a eficiencia enerxética como principios de partida, non como ideas de última hora.
Entra en escena a rede neuronal de Hopfield
Unha rede de Hopfield é unha rede neuronal recorrente formada por unha única capa de neuronas, onde cada neurona está conectada con todas as demais, agás consigo mesma. A rede forma un grafo completo non dirixido — cada par de neuronas comparte un peso de conexión simétrico, é dicir, a forza da neurona i cara á neurona j é idéntica á forza de ja i. Non hai autoconexións (wᵢᵢ = 0). Non hai xerarquía por capas. Non hai unha canalización de procesamento secuencial. En cambio, toda a rede funciona como un único sistema dinámico interconectado que evoluciona co tempo cara a estados de equilibrio estables.
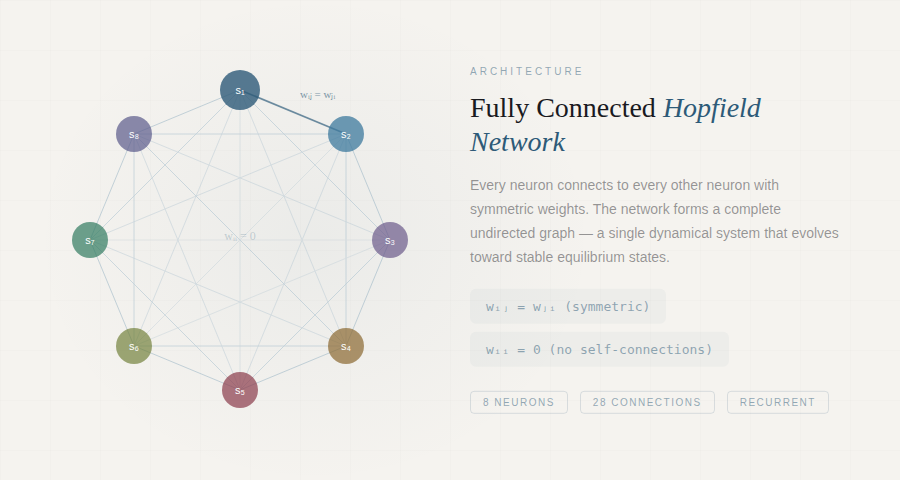
Unha rede de Hopfield con neuronas totalmente conectadas. Cada nodo está unido a todos os demais con pesos simétricos (wᵢⱼ = wⱼᵢ), o que forma un grafo completo non dirixido. Non existen autoconexións.
A elegancia desta arquitectura reside na súa función de enerxía. Hopfield demostrou que a súa rede posúe unha función de enerxía de Lyapunov asociada:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Está garantido que esta enerxía diminúe (ou se mantén constante) con cada actualización dunha neurona. A rede sempre converxe: nunca oscila sen fin, nunca diverxe, nunca queda atrapada en bucles de cálculo infinitos. Estabilízase. En 1990, Bruck demostrou que este comportamento de estabilización está ligado aos cortes do grafo asociado: en cada paso de actualización, a rede executa en esencia un algoritmo voraz para o problema do corte máximo (max-cut).
E é onde a rede se estabiliza onde vive a intelixencia. Os patróns almacenados corresponden aos mínimos locais da función de enerxía, os vales da paisaxe enerxética. Cando lle presentas á rede unha versión corrompida, ruidosa ou incompleta dun patrón almacenado, a dinámica fai rodar o estado da rede costa abaixo ata que cae no vale máis próximo: o patrón almacenado que mellor coincide coa entrada.

A paisaxe enerxética dunha rede de Hopfield. Cada vale (mínimo local) corresponde a un patrón de memoria almacenado. Desde calquera estado inicial, a dinámica da rede rola «costa abaixo» ata asentarse no atractor máis próximo, e recupera o patrón completo a partir dunha entrada parcial ou ruidosa.
Isto é memoria asociativa direccionable por contido a capacidade de recuperar recordos completos a partir de indicios parciais, algo que os cerebros biolóxicos fan sen esforzo pero que os transformers só poden aproximar mediante un cálculo custoso.
A conexión coa física é profunda. A rede de Hopfield é matematicamente equivalente a un modelo de Ising, o mesmo marco que se usa para describir o magnetismo na mecánica estatística. O modelo de vidro de espín de Sherrington-Kirkpatrick, publicado en 1975, é en esencia unha rede de Hopfield con pesos aleatorios. A intuición de Hopfield foi aproveitar esta propiedade de forma deliberada, deseñando a paisaxe enerxética para que cada mínimo corresponda a un patrón útil almacenado.
Aprendizaxe hebbiana: as neuronas que se activan xuntas, conéctanse xuntas
A regra de aprendizaxe que fai funcionar as redes de Hopfield ten raíces aínda máis antigas, que chegan ata o libro de Donald Hebb de 1949, The Organization of Behavior, que propuña o que hoxe se considera o principio fundacional da teoría da aprendizaxe neuronal.
A intuición de Hebb era enganosamente sinxela: cando unha célula presináptica participa de maneira repetida e persistente na activación dunha célula postsináptica, a conexión sináptica entre ambas reforzase. «As neuronas que se activan xuntas, conéctanse xuntas», aínda que o propio Hebb foi máis preciso e subliñou que a célula A ten que participar en provocar que a célula B se active, non simplemente activarse ao mesmo tempo. Esta causalidade temporal anticipaba o que hoxe se coñece como plasticidade dependente do momento dos impulsos (STDP), confirmada experimentalmente décadas despois, incluída a investigación pioneira de Eric Kandel sobre a lesma de mar Aplysia californica.
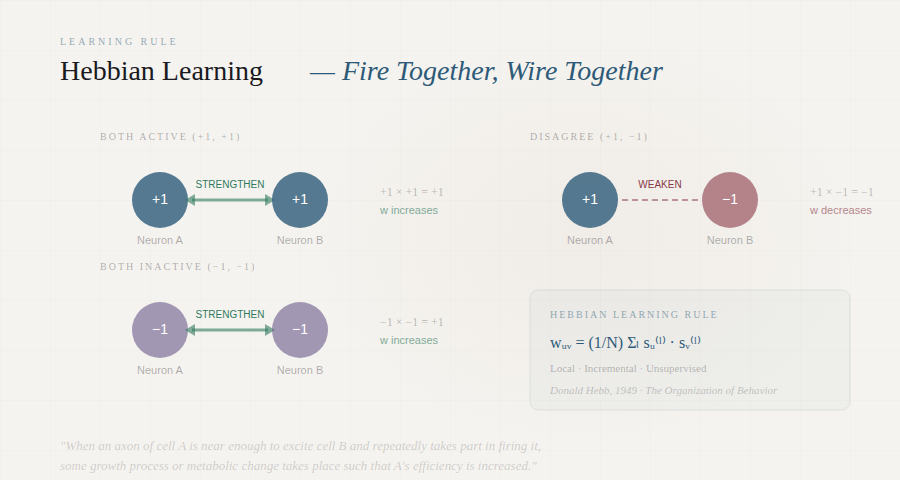
A aprendizaxe hebbiana: cando dúas neuronas conectadas están activas xuntas de forma repetida, a sinapse que as une fortalécese. Este principio, «as neuronas que se activan xuntas conéctanse xuntas», é o fundamento biolóxico de como as redes de Hopfield almacenan patróns.
Na rede de Hopfield, a aprendizaxe hebbiana impleméntase así:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) para todos os patróns almacenados l, onde u ≠ v
Cando dúas neuronas teñen o mesmo estado nun patrón dado (ambas +1 ou ambas −1), o seu produto é positivo e reforza a conexión excitadora. Cando non coinciden, o produto é negativo e crea unha conexión inhibidora. O efecto acumulado esculpe unha paisaxe de enerxía cun val en cada patrón almacenado.
A regra hebbiana é local (cada actualización de peso usa só a información dispoñible para as dúas neuronas conectadas) e incremental (poden almacenarse novos patróns sen reprocesar os antigos). Resulta sorprendente que se poida demostrar matematicamente que a aprendizaxe hebbiana realiza unha análise de compoñentes principais (PCA) non supervisada dos datos de entrada: a rede extrae de forma natural as características estatisticamente máis significativas do seu contorno.
En 1997, Amos Storkey presentou unha regra de aprendizaxe mellorada que ten en conta o campo local en cada neurona e logra unha capacidade de almacenamento maior ca a aprendizaxe hebbiana estándar. Isto mostra que, mesmo dentro da mesma arquitectura, a elección do algoritmo de aprendizaxe importa moito, un principio que fai eco da lección máis ampla da investigación en redes neuronais.
O gran avance: «Hopfield Networks is All You Need»
En 2020, un equipo dirixido por Hubert Ramsauer na Universidade Johannes Kepler de Linz publicou un artigo cun título provocador que lembra a orixe dos transformers: «Hopfield Networks is All You Need». A súa achega foi a proba matemática do que moitos sospeitaban: o mecanismo de autoatención dos transformers é exactamente a regra de actualización dunha rede de Hopfield continua moderna.

A conexión entre as redes de Hopfield modernas e a atención dos transformers. O mecanismo de atención baseado en softmax dos transformers é matematicamente equivalente a un paso de actualización dunha rede de Hopfield continua cunha función de enerxía exponencial. Imaxe de Ramsauer et al., «Hopfield Networks is All You Need».
Non era só unha analoxía. O equipo demostrou que, ao xeneralizar a función de enerxía clásica de Hopfield a estados continuos e usar un termo de interacción exponencial, a regra de actualización resultante queda así:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
que é precisamente a fórmula de atención dos transformers. A rede de Hopfield moderna pode almacenar un número exponencial de patróns (segundo a dimensión do espazo asociativo), recupéraos nunha única actualización e ten erros de recuperación exponencialmente pequenos.
O artigo identificou tres tipos de mínimos de enerxía neste marco moderno: (1) un punto fixo global que fai a media de todos os patróns almacenados, (2) estados metaestables que fan a media de subconxuntos de patróns e (3) puntos fixos que almacenan patróns individuais. As cabezas do transformer das capas inferiores tenden a operar no réxime de media global, mentres que as das capas superiores usan estados metaestables para recoller e procesar información, un achado que ofrece unha visión profunda de por que os transformers funcionan como funcionan.
A implicación práctica foi inmediata: o equipo publicou as capas de Hopfieldcomo módulos PyTorch intercambiables que poderían substituír as capas de pooling, as capas GRU/LSTM e as capas de atención estándar. Nas probas de rendemento, estas capas Hopfield acadaron resultados de vangarda na clasificación de repertorios inmunes (con varios centos de miles de instancias por mostra), en problemas de aprendizaxe de múltiples instancias e nos bancos de probas de clasificación da UCI, onde os métodos tradicionais de aprendizaxe profunda adoitan ter dificultades.
En decembro de 2025, un artigo de NeurIPS de Masumura e Taki foi máis alá e demostrou que ir máis aló da «aproximación adiabática» revela estados ocultos na correspondencia entre Hopfield e os transformers, capaces de resolver os problemas de colapso de rango e de uniformidade dos tokens que afectan aos transformers profundos, mellorando a precisión sen engadir ningún parámetro de adestramento.
Un consenso crecente: quen máis o está dicindo?
Este argumento de que as redes de Hopfield representan o seguinte paradigma despois dos transformers non é unha especulación. Está sendo investigado activamente por grandes institucións de investigación, e as evidencias acumúlanse a gran velocidade. Estas son as voces e os artigos clave que converxen na mesma conclusión.
IBM Research e Dmitry Krotov
En xaneiro de 2025, IBM Research publicou unha extensa entrevista con Dmitry Krotov, colaborador de longa data de Hopfield e un dos arquitectos da Dense Associative Memory. Krotov defendeuno sen rodeos: como as redes de Hopfield reflicten os bucles de retroalimentación recorrentes do cerebro, a diferenza da arquitectura feedforward do 90 % dos modelos de IA actuais, representan «unha alternativa prometedora ás redes feedforward de hoxe». Sinalou que os transformers procesan a información nun só sentido e que, a medida que as xanelas de contexto se fan máis longas, a complexidade computacional dispárase. O cerebro, en cambio, usa bucles de retroalimentación recorrentes para resumir e almacenar na memoria a información pasada. As redes de Hopfield funcionan do mesmo xeito.
Krotov tamén describiu o Energy Transformer (NeurIPS 2023), unha colaboración entre IBM Research e Georgia Tech que non se limita a engadir as ideas de Hopfield aos transformers existentes: substitúe toda a secuencia de bloques transformer feedforward por un único modelo grande de memoria asociativa. O mecanismo de atención do Energy Transformer é explicitamente distinto da atención convencional: deriva dos primeiros principios da minimización da enerxía, non vén remendado sobre un fluxo feedforward.
🔗 IBM Research «Searching for brain-inspired AI algorithms» (xan. 2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Johannes Kepler University - o grupo de Hochreiter
Sepp Hochreiter, co-inventor da LSTM, dirixiu o equipo que publicou «Hopfield Networks is All You Need». O seu repositorio de capas Hopfield ofrece módulos PyTorch listos para produción que serven como substitutos directos das capas de atención dos transformers, das capas de pooling e das capas recorrentes. A publicación do blog complementaria percorre a derivación matemática que mostra que a fórmula de atención softmax é un caso particular da regra de actualización de Hopfield moderna e que as capas Hopfield ofrecen funcionalidades adicionais que a atención estándar non pode proporcionar, como os prototipos estáticos aprendidos e as configuracións flexibles de memoria asociativa.
🔗 Hopfield Networks is All You Need - ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
A evidencia máis recente procede do artigo de NeurIPS de decembro de 2025 de Masumura e Taki. Demostraron que Atención Hopfield moderna (MHA) que engade estados ocultos derivados da dinámica de Hopfield completa (non adiabática), mellora de forma sistemática tanto os modelos de linguaxe GPT-2 e LLaMA como os Vision Transformers. As melloras chegaron sen ningún parámetro de adestramento adicional. Máis importante aínda: comprobouse que a MHA resolve o problema do colapso de rango (cando as matrices de atención dos transformers profundos degeneran e todos os tokens converxen en representacións semellantes), unha patoloxía fundamental que lastrou os intentos de escalar os transformers. Os autores concluíron: «Agardamos que esta investigación abra novas posibilidades para o deseño sistemático de arquitecturas Transformer a partir das redes de Hopfield.»
🔗 Sobre o papel dos estados ocultos da rede de Hopfield moderna nos Transformers, arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: aprendizaxe en liña biolóxicamente plausible
En maio de 2024, Nature Communications publicou un traballo sobre a Sparse Quantized Hopfield Network (rede de Hopfield cuantizada e esparsa), un modelo que aprende con regras de aprendizaxe locais en escenarios continuos e en liña, xusto como fan os cerebros biolóxicos. Isto responde a unha limitación de fondo dos transformers, que precisan retropropagación non local e adestramento fóra de liña con datos xa seleccionados. O artigo presenta as arquitecturas baseadas en Hopfield como a ponte natural entre as redes neuronais artificiais e o hardware de computación neuromórfica.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory, Nature Communications (2024)
Capas de Hopfield eficientes con valores atípicos para grandes modelos fundacionais
Un artigo de 2024 abordou un problema práctico dos grandes modelos transformer: a tendencia a repartir atención entre tokens sen información (delimitadores, signos de puntuación), o chamado problema dos «valores atípicos sen operación» (no-op outliers). A súa solución foi unha función de enerxía de Hopfield eficiente con valores atípicos que clasifica eses tokens e os envía a un punto de enerxía cero, para que non diluúan a atención útil. O modelo resultante inclúe a atención Softmax₁ como caso particular e foi validado en BERT, OPT e Vision Transformers. É a teoría de Hopfield resolvendo problemas reais da enxeñaría dos transformers.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Os transformers como minimizadores de enerxía (xaneiro de 2026)
O traballo teórico máis recente, publicado en xaneiro de 2026, presenta todo o paso cara adiante do transformer como unha minimización de enerxía intrínseca, e adopta por completo a perspectiva de Hopfield como marco para explicar por que funcionan os transformers. O artigo conecta os modelos de Hopfield modernos esparsos coa familia completa de variantes de atención (softmax, sparsemax, α-entmax) e mostra que todas son casos particulares dunha dinámica de recuperación baseada na enerxía.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (xan. de 2026)
Artigos de revisión e recursos da comunidade
A comunidade investigadora en xeral está a organizarse arredor desta converxencia:
- «Energy-Based Learning and the Evolution of Hopfield Networks» (TechRxiv, abril de 2025) Unha revisión completa que percorre todo o arco, desde Hopfield (1982) e as máquinas de Boltzmann ata a reinterpretación da atención dos transformers como dinámica de Hopfield moderna. → Le o artigo
- «An Energy-Based Perspective on Attention Mechanisms in Transformers» Un blog técnico en profundidade que defende que entender os transformers a través da lente enerxética de Hopfield «podería levar a melloras cualitativamente distintas, máis aló do que se pode lograr só con escala e reducindo a complexidade computacional». → Ler o blog
- Awesome Modern Hopfield Networks Un repositorio de GitHub coidadosamente seleccionado que reúne máis de 50 artigos sobre as redes de Hopfield modernas en distintos ámbitos: asignación de activos, detección de cambios, reconstrución do pensamento creativo, detección de datos fóra de distribución, clasificación de repertorios inmunes e moito máis. → Explorar a colección
- "Is Hopfield Networks All You Need?" (Analytics India Magazine, decembro de 2024) Unha cobertura orientada ao profesional sobre como o equipo de Hochreiter demostrou que as redes de Hopfield son «intercambiables cos modelos transformer máis avanzados». → Ler o artigo
- "New Research in Hopfield Networks: A Short Intro" (Medium, xullo de 2024) Unha visión xeral accesible que sinala que a capacidade de almacenamento pasou de 0,138N a 2^(N/2) grazas ás funcións de activación exponenciais. → Ler en Medium
A traxectoria é clara. Esta non é a proposta dun só laboratorio nin a especulación dun só artigo. IBM Research, a Johannes Kepler University, o MIT, NeurIPS, Nature Communications e o conxunto da comunidade do aprendizaxe automática converxen na mesma conclusión desde direccións distintas: o paradigma da memoria asociativa baseada na enerxía que estableceu Hopfield non é só o fundamento sobre o que, sen sabelo, se construíron os transformers, senón o marco que levará a IA máis aló do que os transformers poden acadar por si sós.
Por que importa agora: o argumento para cambiar
Converxencia garantida para sistemas críticos para a seguridade
Os transformers producen saídas, pero non hai ningunha garantía matemática de estabilidade. As redes de Hopfield converxen a estados estables por demostración a función de enerxía diminúe de forma monótona. Para a robótica, os vehículos autónomos, os dispositivos médicos e calquera sistema onde a fiabilidade non é negociable, este é un requisito que os transformers non poden ofrecer.
A memoria asociativa como capacidade central
Se adestras unha rede de Hopfield para que o estado (1, −1, 1, −1, 1) sexa un mínimo de enerxía e lle presentas a entrada corrompida (1, −1, −1, −1, 1), a rede converxe ao patrón almacenado correcto. Non adiviña nin interpola: rueda costa abaixo pola paisaxe de enerxía ata o atractor máis próximo. Para a robótica con sensores ocluídos, os sistemas embebidos con datos ruidosos e calquera aplicación que precise completar patróns a partir dunha entrada parcial, isto é transformador.
Un motor universal de optimización
Hopfield e David Tank demostraron en 1985 que as redes de Hopfield poden resolver o problema do caixeiro viaxante. Se unha función de custo se pode escribir coa forma da enerxía de Hopfield, os puntos de equilibrio da rede son as solucións. Desde entón, a arquitectura aplicouse á planificación de talleres (job-shop scheduling), á asignación de canles en redes sen fíos, á restauración de imaxes, á conversión analóxico-dixital, ao encamiñamento móbil e á optimización combinatoria. Un artigo de Nature Communications de 2024 presentou unha Sparse Quantized Hopfield Network para a aprendizaxe de memoria continua en liña con regras locais, do mesmo xeito que o fan os cerebros biolóxicos, unha capacidade da que os transformers carecen de raíz.
Hardware que pensa sen software
A restrición de pesos simétricos (wᵢⱼ = wⱼᵢ) correspóndese directamente cos circuítos electrónicos analóxicos: unha conexión resistiva é simétrica por natureza. As redes de Hopfield pódense fabricar como ASIC ou FPGA, con inferencia en escalas de tempo de nanosegundos. A colección de Nature de 2025 sobre computación neuromórfica confirma esta dirección: hardware analóxico eficiente en enerxía que implementa dinámicas neuronais na periferia da rede, con memoria direccionable por contido que non precisa GPU, nin CPU, nin pila de software.
Chips de IA neuromórficos e analóxicos que implementan a dinámica das redes neuronais directamente en hardware. A estrutura simétrica e baseada na enerxía das redes de Hopfield encaixa de maneira natural nos circuítos resistivos, o que permite inferencia de IA en escalas de nanosegundos sen as pilas de software tradicionais.
Flexibilidade binaria e continua
As redes de Hopfield clásicas empregan neuronas binarias (+1 ou −1); as variantes continuas usan activación sigmoide e ecuacións diferenciais. As actualizacións poden ser asíncronas (unha neurona de cada vez, o que garante a converxencia) ou síncronas (todas á vez, o que permite o paralelismo). A mesma arquitectura adáptase desde un microcontrolador con kilobytes de RAM ata unha FPGA masivamente paralela e, agora, cunhas capas de Hopfield modernas, ata os pipelines de aprendizaxe profunda acelerados por GPU.
Capacidade de almacenamento: a limitación honesta
A limitación clásica é clara: unha rede de N neuronas almacena de forma fiable aproximadamente 0.138N patróns antes de que os estados espurios degraden a recuperación. É unha limitación real, pero é unha limitación honesta. Os transformers non teñen un límite matemático claro que diga cando empezarán a alucinar.
Ademais, as redes de Hopfield modernas (Krotov & Hopfield, 2016; Demircigil et al., 2017) logran unha capacidade de almacenamento exponencial grazas a termos de interacción de orde superior. A investigación segue ampliando estes límites: as redes de Hopfield esparsas e estruturadas, a memoria de Hopfield para secuencias longas e as redes de Hopfield para a asignación de activos son áreas en pleno desenvolvemento, con artigos que se acumulan a gran velocidade.
Despregamento práctico: dos PCs aos circuítos
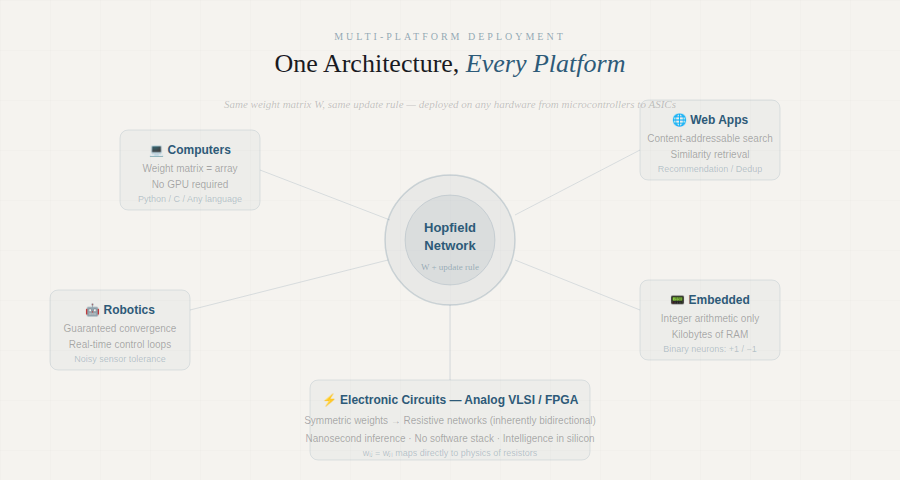
A visión orixinal dos primeiros investigadores das redes neuronais era clara: un marco que se puidese describir unha vez e despregar en calquera parte. A arquitectura de Hopfield faino realidade:
Aplicacións informáticas Unha matriz de pesos e unha regra de actualización. Sen necesidade de GPU.
Aplicacións de internet Memoria direccionable por contido para a busca por similitude, a recomendación e a eliminación de duplicados.
Robótica Converxencia garantida para bucles de control en tempo real. Os patróns de movemento gárdanse como atractores e recupéranse mesmo a partir de sinais de sensores con ruído.
Sistemas embebidos As redes de Hopfield binarias funcionan en microcontroladores só con aritmética de enteiros.
Circuítos electrónicos Os pesos simétricos corresponden a redes resistivas. A intelixencia fabricada directamente en silicio.
O camiño por diante
A era dos transformers deunos máquinas de linguaxe extraordinarias. Pero a fronteira esténdese agora ao mundo físico: robots, sensores, actuadores e decisións en tempo real. Esa fronteira esixe arquitecturas estables, eficientes, interpretables e que se poidan despregar no hardware que de verdade existe na periferia da rede (edge).
A demostración de 2020 de que a atención dos transformers é unha regra de actualización de Hopfield moderna non foi só unha curiosidade matemática: revelou que levabamos todo este tempo empregando redes de Hopfield, envoltas nun marco que agochaba a súa verdadeira natureza. O traballo de NeurIPS de 2025, que mostra que os estados ocultos de Hopfield resolven patoloxías dos transformers como o colapso de rango, apunta ao seguinte paso: non remendar os transformers con ideas de Hopfield, senón construír directamente sobre o propio paradigma de Hopfield.
John Hopfield amosounos o camiño en 1982. Donald Hebb puxo as bases biolóxicas en 1949. A comunidade investigadora converxe agora nel.
É hora de cambiar.
Referencias
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of Behavior. Wiley.
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, abril de 2025. techrxiv.org

