

Hebbian Learning ontmoet Hopfield-netwerken: de architectuur die altijd slimmer was dan transformers
Het afgelopen decennium hebben transformers en hun aandachtsmechanismen (attention) het AI-landschap gedomineerd. Van GPT tot BERT en Vision Transformers: het adagium "attention is all you need" veranderde hoe we over machine learning denken. Vertaalsystemen, encoder-decoder-pipelines die data omzetten tussen verschillende representaties, werden de ruggengraat van alles, van taalverwerking tot beeldgeneratie. Ze waren revolutionair. Ze waren krachtig.
En nu lopen ze tegen een muur aan.
De ironie is dat de oplossing al sinds 1982 bestaat. In dat jaar publiceerde John Hopfield in de Proceedings of the National Academy of Sciences een artikel over een recurrent neuraal netwerk met een eigenschap die transformers nooit echt hebben bereikt: gegarandeerde convergentie naar stabiele toestanden door energieminimalisatie. Het Hopfield-netwerk leerde patronen niet alleen, het sloeg ze op als fysieke attractoren in een energielandschap, terug te halen, zelfs uit ruis of onvolledige invoer.
De AI-gemeenschap begint pas nu te beseffen wat natuurkundigen en neurowetenschappers al ttientallen jaren weten: de energiegebaseerde, associatieve benadering van neurale berekening is geen historische curiositeit, maar een fundamenteel paradigma waarop het transformertijdperk heeft voortgebouwd zonder het volledig te begrijpen.
Het transformerplafond
Transformers berekenen via self-attention de relaties tussen elk element in een reeks tegelijk. Dat is briljant voor taal. Het is briljant voor gestructureerde data met duidelijke sequentiële patronen. Maar de echte wereld, die van robotica, ingebedde schakelingen, sensorgestuurde besluitvorming en edge computing, ordent zichzelf niet in nette reeksen die erop wachten dat er aandacht aan wordt besteed.
De transformerarchitectuur gaat uit van overvloed: overvloedige rekenkracht, overvloedig geheugen, overvloedig vermogen. Self-attention schaalt kwadratisch met de lengte van de reeks. Feed-forward-lagen groeien lineair, maar enorm. Zodra je een op transformers gebaseerd systeem inzet op een mobiele robot die door een magazijn navigeert, of het inbouwt in een elektronische schakeling die een productiearm aanstuurt, storten die aannames in.
Het vertaalparadigma heeft bovendien een eigen beperking: het behandelt intelligentie vooral als een conversieprobleem tussen vaste representaties. Codeer de invoer. Decodeer de uitvoer. Maar echte intelligentie vertaalt niet alleen, ze onthoudt, ze associeert en ze convergeert naar stabiele interpretaties, ook als de invoer vervormd of dubbelzinnig is.
We hebben deze problemen gepatcht met kwantisatie, distillatie, pruning en honderd andere optimalisatietrucs. Edge-AI-overzichtsstudies uit 2025 bevestigen dat het inzetten van deep learning op embedded hardware nog steeds "beperkt wordt door strikte grenzen aan geheugen, rekenkracht en energie". Maar het optimaliseren van een fundamenteel misplaatste architectuur stelt de afrekening slechts uit. Wat we nodig hebben, is een architectuur die geheugen, stabiliteit en energie-efficiëntie als uitgangspunten behandelt, niet als bijzaak.
Het Hopfield-neuraal netwerk betreedt het toneel
Een Hopfield-netwerk is een recurrent neuraal netwerk dat bestaat uit één enkele laag neuronen, waarbij elk neuron met elk ander neuron is verbonden, behalve met zichzelf. Het netwerk vormt een volledige ongerichte graaf: elk paar neuronen deelt een symmetrisch verbindingsgewicht, wat betekent dat de sterkte van neuron i naar neuron j gelijk is aan de sterkte van j naar i. Er zijn geen zelfverbindingen (wᵢᵢ = 0). Geen gelaagde hiërarchie. Geen sequentiële verwerkingsketen. In plaats daarvan werkt het hele netwerk als één samenhangend dynamisch systeem dat zich in de loop van de tijd ontwikkelt naar stabiele evenwichtstoestanden.
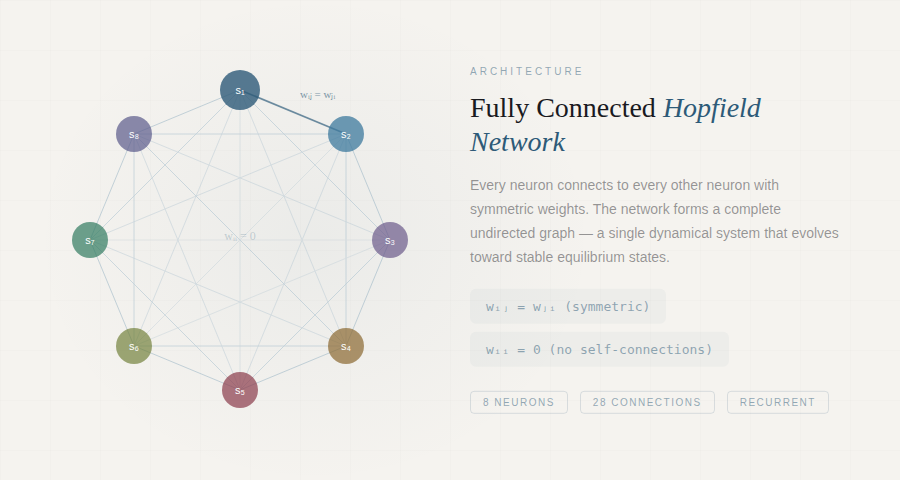
Een Hopfield-netwerk met volledig verbonden neuronen. Elk knooppunt is met elk ander knooppunt verbonden via symmetrische gewichten (wᵢⱼ = wⱼᵢ), waardoor een volledige ongerichte graaf ontstaat. Zelfverbindingen komen niet voor.
De elegantie van deze architectuur zit in de energiefunctie. Hopfield bewees dat zijn netwerk een bijbehorende Lyapunov-energiefunctie heeft:
E = −½ Σᵢ Σⱼ wᵢⱼ sᵢ sⱼ − Σᵢ θᵢ sᵢ
Bij elke update van een neuron daalt deze energie gegarandeerd (of blijft ze gelijk). Het netwerk convergeert dus altijd: het oscilleert nooit eindeloos, loopt nooit uit elkaar en raakt nooit verstrikt in oneindige rekenlussen. Het komt tot rust. In 1990 bewees Bruck dat dit gedrag samenhangt met sneden in de bijbehorende graaf: bij elke updatestap voert het netwerk in feite een greedy-algoritme voor het max-cut-probleem uit.
En waar het netwerk tot rust komt, daar zit de intelligentie. Opgeslagen patronen komen overeen met lokale minima van de energiefunctie, de dalen in het energielandschap. Als je het netwerk een beschadigde, ruisachtige of onvolledige versie van een opgeslagen patroon aanbiedt, rolt de dynamiek de netwerktoestand bergafwaarts tot hij in het dichtstbijzijnde dal valt: het opgeslagen patroon dat het best bij de invoer past.

Het energielandschap van een Hopfield-netwerk. Elk dal (lokaal minimum) komt overeen met een opgeslagen geheugenpatroon. Vanuit elke begintoestand rolt de netwerkdynamiek "bergafwaarts" tot hij in de dichtstbijzijnde attractor tot rust komt en zo het volledige patroon herstelt uit gedeeltelijke of ruisachtige invoer.
Dit is inhoudsadresseerbaar associatief geheugen het vermogen om complete herinneringen op te roepen aan de hand van gedeeltelijke aanwijzingen. Biologische hersenen doen dat moeiteloos, terwijl transformers het slechts met kostbare rekenkracht kunnen benaderen.
De band met de natuurkunde gaat diep. Het Hopfield-netwerk is wiskundig equivalent aan een Ising-model, hetzelfde kader dat in de statistische mechanica wordt gebruikt om magnetisme te beschrijven. Het Sherrington-Kirkpatrick-model van een spinglas, gepubliceerd in 1975, is in wezen een Hopfield-netwerk met willekeurige gewichten. Hopfields inzicht was om deze eigenschap bewust te benutten en het energielandschap zo te ontwerpen dat elk minimum overeenkomt met een nuttig opgeslagen patroon.
Hebbiaans leren: neuronen die samen vuren, verbinden zich samen
De leerregel waarop Hopfield-netwerken draaien, gaat nog verder terug, naar Donald Hebbs boek uit 1949, The Organization of Behavior, dat het principe formuleerde dat nu geldt als het grondbeginsel van de neurale leertheorie.
Hebbs inzicht was bedrieglijk eenvoudig: wanneer een presynaptische cel herhaaldelijk en aanhoudend meewerkt aan het vuren van een postsynaptische cel, wordt de synaptische verbinding tussen beide sterker. "Neuronen die samen vuren, verbinden zich samen", al was Hebb zelf nauwkeuriger: hij benadrukte dat cel A moet meewerken aan het veroorzaken dat cel B vuurt, en niet simpelweg tegelijkertijd moet vuren. Die temporele causaliteit liep vooruit op wat we nu kennen als spike-timing-dependent plasticity (STDP), decennia later experimenteel bevestigd, onder meer door het baanbrekende onderzoek van Eric Kandel aan de zeenaaktslak Aplysia californica.
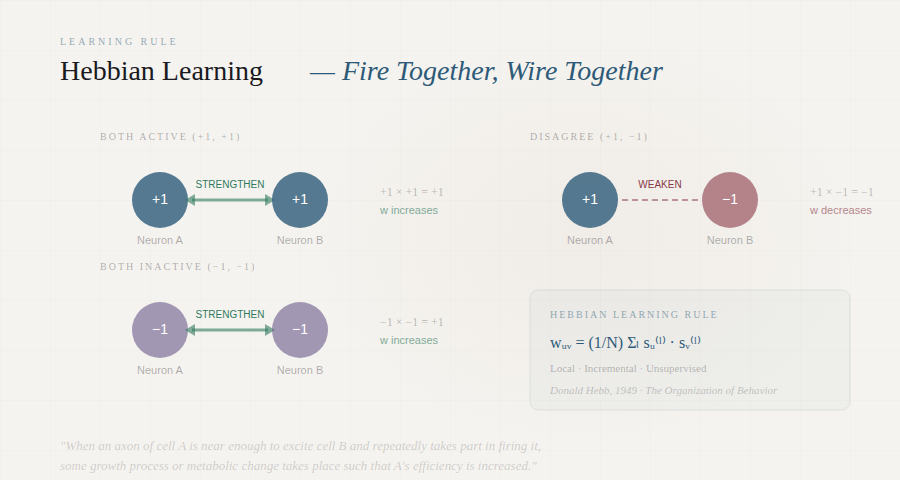
Hebbiaans leren: wanneer twee verbonden neuronen herhaaldelijk tegelijk actief zijn, wordt de synaps tussen beide sterker. Dit principe, "neurons that fire together wire together" (neuronen die samen vuren, raken samen verbonden), is de biologische basis van de manier waarop Hopfield-netwerken patronen opslaan.
In het Hopfield-netwerk wordt hebbiaans leren als volgt toegepast:
wᵤᵥ = (1/N) Σₗ sᵤ(l) · sᵥ(l) voor alle opgeslagen patronen l, waarbij u ≠ v
Hebben twee neuronen in een bepaald patroon dezelfde toestand (beide +1 of beide −1), dan is hun product positief en wordt de exciterende verbinding sterker. Verschillen ze van toestand, dan is het product negatief en ontstaat er een remmende verbinding. Het gezamenlijke effect boetseert een energielandschap met in elk opgeslagen patroon een dal.
De regel van Hebb is lokaal (elke gewichtsaanpassing gebruikt alleen informatie waarover de twee verbonden neuronen beschikken) en incrementeel (nieuwe patronen kunnen worden opgeslagen zonder de oude opnieuw te verwerken). Opmerkelijk genoeg laat zich wiskundig aantonen dat hebbiaans leren een ongesuperviseerde hoofdcomponentenanalyse (PCA) van de invoerdata uitvoert: het netwerk haalt als vanzelf de statistisch meest betekenisvolle kenmerken uit zijn omgeving.
In 1997 introduceerde Amos Storkey een verbeterde leerregel die rekening houdt met het lokale veld van elk neuron en daardoor een grotere opslagcapaciteit haalt dan standaard hebbiaans leren. Het laat zien dat zelfs binnen dezelfde architectuur de keuze van het leeralgoritme er sterk toe doet, een inzicht dat aansluit bij de bredere les uit het onderzoek naar neurale netwerken.
De doorbraak: "Hopfield Networks is All You Need"
In 2020 publiceerde een team onder leiding van Hubert Ramsauer van de Johannes Kepler Universiteit Linz een artikel met een uitdagende titel, een echo van het ontstaansverhaal van de transformer: "Hopfield Networks is All You Need." Hun bijdrage was het wiskundige bewijs van iets wat velen al vermoedden: het self-attention-mechanisme in transformers is precies de updateregel van een modern continu Hopfield-netwerk.

Het verband tussen moderne Hopfield-netwerken en de attention van transformers. Het op softmax gebaseerde attention-mechanisme in transformers is wiskundig gelijkwaardig aan één updatestap van een continu Hopfield-netwerk met een exponentiële energiefunctie. Afbeelding uit Ramsauer et al., "Hopfield Networks is All You Need."
Dit was niet louter een analogie. Het team liet zien dat de updateregel, door de klassieke Hopfield-energiefunctie te veralgemeniseren naar continue toestanden en een exponentiële interactieterm te gebruiken, de volgende vorm krijgt:
Z = softmax(β · R Wq Wk⊤ Y⊤) Y Wk Wv
en dat is precies de attention-formule van de transformer. Het moderne Hopfield-netwerk kan exponentieel veel patronen opslaan (afhankelijk van de dimensie van de associatieve ruimte), haalt ze op in één enkele updatestap en heeft exponentieel kleine ophaalfouten.
Het artikel onderscheidt in dit moderne raamwerk drie typen energieminima: (1) een globaal vast punt dat het gemiddelde neemt over alle opgeslagen patronen, (2) metastabiele toestanden die het gemiddelde nemen over deelverzamelingen van patronen, en (3) vaste punten die één enkel patroon opslaan. Transformer-heads in de lagere lagen werken doorgaans in het regime van globale middeling, terwijl heads in hogere lagen metastabiele toestanden gebruiken om informatie te verzamelen en te verwerken, een bevinding die diep inzicht geeft in waarom transformers werken zoals ze werken.
De praktische gevolgen waren direct merkbaar: het team bracht Hopfield-lagenals drop-in PyTorch-modules die poolinglagen, GRU/LSTM-lagen en standaard attention-lagen kunnen vervangen. In benchmarks behaalden deze Hopfield-lagen state-of-the-art resultaten bij de classificatie van immuunrepertoires (met enkele honderdduizenden instanties per sample), bij multiple-instance-learningproblemen en bij UCI-classificatiebenchmarks, waar traditionele deep-learningmethoden doorgaans moeite mee hebben.
In december 2025 ging een NeurIPS-paper van Masumura en Taki nog een stap verder: zij lieten zien dat je door voorbij de 'adiabatische benadering' te gaan verborgen toestanden blootlegt in de overeenkomst tussen Hopfield-netwerken en transformers. Die toestanden kunnen de problemen van rank collapse en token-uniformiteit oplossen die diepe transformers parten spelen, en verbeteren de nauwkeurigheid zonder één extra trainingsparameter.
Een groeiende consensus: wie zegt dit nog meer?
De stelling dat Hopfield-netwerken het volgende paradigma na de transformers vormen, is geen speculatie. Grote onderzoeksinstellingen werken er actief aan en het bewijs stapelt zich snel op. Dit zijn de belangrijkste stemmen en papers die tot dezelfde conclusie komen.
IBM Research en Dmitry Krotov
In januari 2025 publiceerde IBM Research een uitgebreid interview met Dmitry Krotov, Hopfields langjarige medewerker en een van de architecten van Dense Associative Memory. Krotov bracht het rechtstreeks naar voren: omdat Hopfield-netwerken de terugkerende feedbacklussen van de hersenen nabootsen, anders dan de feedforward-architectuur van 90% van de huidige AI-modellen, vormen ze "een veelbelovend alternatief voor de feedforward-netwerken van nu." Hij wees erop dat transformers informatie maar in één richting verwerken en dat de rekenkundige complexiteit snel toeneemt naarmate de contextvensters groter worden. De hersenen gebruiken daarentegen recurrente feedbacklussen om eerdere informatie samen te vatten en in het geheugen op te slaan. Hopfield-netwerken werken op dezelfde manier.
Krotov beschreef ook de Energy Transformer (NeurIPS 2023), een samenwerking tussen IBM Research en Georgia Tech die Hopfield-inzichten niet simpelweg over bestaande transformers heen legt, maar de hele reeks feedforward-transformerblokken vervangt door één groot Associative Memory-model. Het attentionmechanisme in de Energy Transformer verschilt nadrukkelijk van conventionele attention: het is afgeleid uit de basisprincipes van energieminimalisatie en niet achteraf op een feedforward-pijplijn geplakt.
🔗 IBM Research: "Searching for brain-inspired AI algorithms" (jan. 2025)
🔗 Energy Transformer arXiv:2302.07253 (NeurIPS 2023)
Johannes Kepler Universiteit - de groep van Hochreiter
Sepp Hochreiter, mede-uitvinder van de LSTM, leidde het team dat "Hopfield Networks is All You Need" publiceerde. Hun Hopfield layers-repository biedt productieklare PyTorch-modules die als drop-in vervanging dienen voor transformer-attentionlagen, poolinglagen en recurrente lagen. De bijbehorende blogpost leidt stap voor stap de wiskundige afleiding af waaruit blijkt dat de softmax-attentionformule een speciaal geval is van de moderne Hopfield-updateregel, en dat Hopfield-lagen extra functionaliteit bieden die standaard attention niet kan leveren, waaronder statische aangeleerde prototypes en flexibele configuraties van associatief geheugen.
🔗 Hopfield Networks is All You Need - ICLR 2021
NeurIPS 2025: Hopfield Attention Improves GPT and Vision Transformers
Het meest recente bewijs komt uit het NeurIPS-paper van Masumura en Taki van december 2025. Zij lieten zien dat Modern Hopfield Attention (MHA) die verborgen toestanden toevoegt, afgeleid van de volledige (niet-adiabatische) Hopfield-dynamica, verbetert systematisch zowel GPT-2- en LLaMA-taalmodellen als Vision Transformers. De verbeteringen kwamen zonder enige extra trainingsparameters. Belangrijker nog: MHA bleek het probleem van rank collapse op te lossen (waarbij aandachtsmatrices in diepe transformers degenereren, waardoor alle tokens naar vergelijkbare representaties convergeren), een fundamentele kwaal die de opschaling van transformers al lang parten speelt. De auteurs concluderen: "We hopen dat dit onderzoek nieuwe mogelijkheden opent voor het systematisch ontwerpen van Transformer-architecturen met Hopfield-netwerken."
🔗 On the Role of Hidden States of Modern Hopfield Network in Transformer arXiv:2511.20698 (NeurIPS 2025)
Nature Communications: biologisch plausibel online leren
In mei 2024 publiceerde Nature Communications onderzoek naar het Sparse Quantized Hopfield Network, een model dat leert met lokale leerregels in online-continue scenario's, precies zoals biologische hersenen dat doen. Dit pakt een fundamentele beperking van transformers aan, die niet-lokale backpropagation en offline training op samengestelde datasets nodig hebben. Het artikel plaatst op Hopfield gebaseerde architecturen als de natuurlijke brug tussen kunstmatige neurale netwerken en neuromorfe computerhardware.
🔗 A Sparse Quantized Hopfield Network for Online-Continual Memory Nature Communications (2024)
Outlier-efficiënte Hopfield-lagen voor grote foundationmodellen
Een paper uit 2024 pakte een praktisch probleem in grote transformermodellen aan: de neiging om aandacht te besteden aan niet-informatieve tokens (scheidingstekens, leestekens), het "no-op outlier"-probleem. Hun oplossing was een outlier-efficiënte Hopfield-energiefunctie die deze tokens classificeert en naar een punt van nul energie stuurt, zodat ze de nuttige aandacht niet verdunnen. Het resulterende model omvat Softmax₁-attention als bijzonder geval en is gevalideerd op BERT, OPT en Vision Transformers. Dit is Hopfield-theorie die echte engineeringproblemen van transformers oplost.
🔗 Outlier-Efficient Hopfield Layers for Large Transformer-Based Models (2024)
Transformers als energieminimalisatoren (januari 2026)
Het meest recente theoretische werk, gepubliceerd in januari 2026, beschrijft de volledige forward pass van een transformer als intrinsieke energieminimalisatie. Daarmee omarmt het het Hopfield-perspectief volledig als verklaringskader voor de vraag waarom transformers eigenlijk werken. Het artikel verbindt sparse moderne Hopfield-modellen met de hele familie van attention-varianten (softmax, sparsemax, α-entmax) en laat zien dat ze allemaal bijzondere gevallen zijn van energiegebaseerde retrievaldynamica.
🔗 Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle (jan. 2026)
Overzichtsartikelen en bronnen uit de community
De bredere onderzoeksgemeenschap organiseert zich rond deze convergentie:
- "Energy-Based Learning and the Evolution of Hopfield Networks" (TechRxiv, april 2025) Een uitgebreid overzicht dat de hele lijn schetst van Hopfield (1982) via Boltzmann-machines tot de herinterpretatie van transformer-attention als moderne Hopfield-dynamica. → Lees het artikel
- "An Energy-Based Perspective on Attention Mechanisms in Transformers" Een diepgaande technische blog die betoogt dat het begrijpen van transformers door de Hopfield-energielens "kan leiden tot kwalitatief andere verbeteringen dan wat mogelijk is met alleen opschaling en het verlagen van de rekencomplexiteit." → Lees de blog
- Awesome Modern Hopfield Networks Een zorgvuldig samengestelde GitHub-repository met meer dan 50 artikelen over moderne Hopfield-netwerken in uiteenlopende domeinen: vermogensallocatie, detectie van veranderingen, reconstructie van creatieve gedachten, detectie van out-of-distribution-data, classificatie van immuunrepertoires en meer. → Bekijk de collectie
- "Is Hopfield Networks All You Need?" (Analytics India Magazine, dec. 2024) Praktijkgerichte verslaggeving over hoe het team van Hochreiter liet zien dat Hopfield-netwerken "uitwisselbaar zijn met de modernste transformer-modellen". → Lees het artikel
- "New Research in Hopfield Networks: A Short Intro" (Medium, juli 2024) Toegankelijk overzicht waarin wordt opgemerkt dat de opslagcapaciteit dankzij exponentiële activeringsfuncties is gegroeid van 0,138N naar 2^(N/2). → Lees op Medium
De lijn is duidelijk. Dit is niet het voorstel van één lab of de speculatie van één paper. IBM Research, de Johannes Kepler Universiteit, MIT, NeurIPS, Nature Communications en de bredere machine-learninggemeenschap komen vanuit verschillende richtingen tot dezelfde conclusie: het energiegebaseerde, associatieve geheugenparadigma dat Hopfield introduceerde is niet alleen het fundament waarop transformers onbewust zijn gebouwd, maar ook het raamwerk dat AI verder zal brengen dan transformers alleen ooit kunnen bereiken.
Waarom dit nu telt: de argumenten om over te stappen
Gegarandeerde convergentie voor veiligheidskritieke systemen
Transformers leveren uitvoer, maar er is geen wiskundige garantie voor stabiliteit. Hopfield-netwerken convergeren aantoonbaar naar stabiele toestanden de energiefunctie neemt monotoon af. Voor robotica, zelfrijdende voertuigen, medische apparatuur en elk systeem waarbij betrouwbaarheid niet onderhandelbaar is, is dit een eis waaraan transformers niet kunnen voldoen.
Associatief geheugen als kernvermogen
Stel dat je een Hopfield-netwerk zo traint dat toestand (1, −1, 1, −1, 1) een energieminimum is, en je geeft het beschadigde invoerpatroon (1, −1, −1, −1, 1) aan het netwerk. Dan convergeert het netwerk naar het juiste opgeslagen patroon. Het gokt niet en interpoleert niet het rolt bergafwaarts door het energielandschap naar de dichtstbijzijnde attractor. Voor robotica met afgedekte sensoren, embedded systemen met ruisgevoelige data en elke toepassing die patronen moet aanvullen op basis van gedeeltelijke invoer is dit een doorbraak.
Een universele optimalisatiemotor
Hopfield en David Tank toonden in 1985 aan dat Hopfield-netwerken het handelsreizigersprobleem kunnen oplossen. Als een kostenfunctie kan worden geschreven in de vorm van de Hopfield-energie, dan zijn de evenwichtspunten van het netwerk de oplossingen. Sindsdien is de architectuur toegepast op jobshop-planning, kanaaltoewijzing in draadloze netwerken, beeldrestauratie, analoog-naar-digitaalconversie, mobiele routering en combinatorische optimalisatie. Een artikel in Nature Communications uit 2024 introduceerde een Sparse Quantized Hopfield Network voor online, continu lerend geheugen met lokale regels, op dezelfde manier als biologische hersenen dat doen: een vermogen dat transformers fundamenteel missen.
Hardware die denkt zonder software
De eis van symmetrische gewichten (wᵢⱼ = wⱼᵢ) laat zich direct vertalen naar analoge elektronische schakelingen een weerstandsverbinding is van nature symmetrisch. Hopfield-netwerken kunnen worden gefabriceerd als ASIC's of FPGA's, met inferentie op nanoseconde-schaal. Nature's collectie over neuromorfisch rekenen uit 2025 bevestigt deze richting: energiezuinige analoge hardware die neurale dynamiek op de edge uitvoert, met inhoudsadresseerbaar geheugen dat geen GPU, geen CPU en geen softwarestack nodig heeft.
Neuromorfe en analoge AI-chips die de dynamiek van neurale netwerken rechtstreeks in hardware uitvoeren. De symmetrische, energiegebaseerde structuur van Hopfield-netwerken sluit van nature aan op resistieve schakelingen. Zo wordt AI-inferentie op nanoseconde-schaal mogelijk, zonder traditionele softwarestacks.
Binair en continu: flexibel in beide richtingen
Klassieke Hopfield-netwerken gebruiken binaire neuronen (+1 of −1); continue varianten werken met sigmoïde activatie en differentiaalvergelijkingen. Updates kunnen asynchroon verlopen (één neuron tegelijk, wat convergentie garandeert) of synchroon (alles tegelijk, wat parallelle verwerking mogelijk maakt). Dezelfde architectuur past zich aan van een microcontroller met kilobytes RAM tot een massaal parallelle FPGA en, met moderne Hopfield-lagen, nu ook tot GPU-versnelde deep-learningpipelines.
Opslagcapaciteit: de eerlijke beperking
De klassieke beperking is duidelijk: een netwerk van N neuronen slaat betrouwbaar ongeveer 0,138N patronen op, voordat valse toestanden het terugvinden gaan verstoren. Dat is een echte beperking, maar wel een eerlijke. Transformers hebben geen heldere wiskundige grens die zegt wanneer ze beginnen te hallucineren.
Bovendien bereiken moderne Hopfield-netwerken (Krotov & Hopfield, 2016; Demircigil et al., 2017) exponentiële opslagcapaciteit dankzij interactietermen van hogere orde. Het onderzoek blijft deze grenzen verleggen: ijle (sparse) en gestructureerde Hopfield-netwerken, Hopfield-geheugen voor lange sequenties en Hopfield-netwerken voor vermogensallocatie zijn allemaal actieve ontwikkelgebieden, met een snel groeiend aantal publicaties.
Praktische toepassing: van pc's tot schakelingen
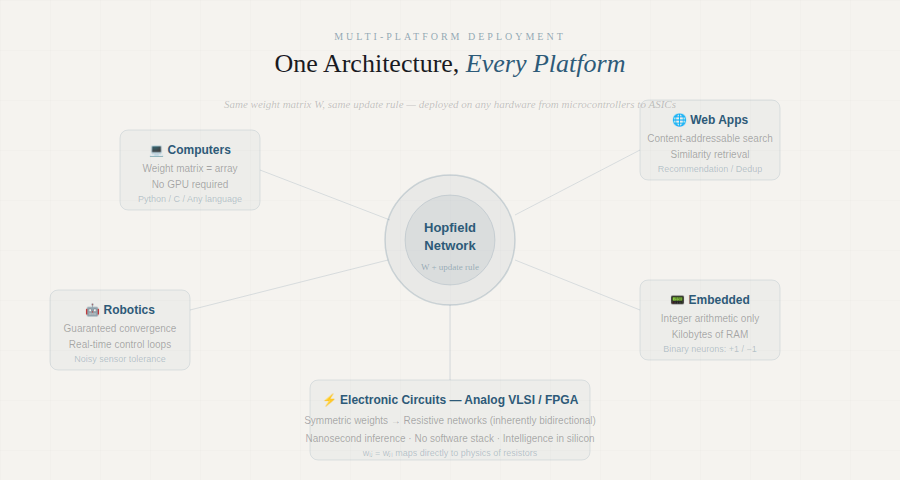
De oorspronkelijke visie van de eerste onderzoekers naar neurale netwerken was helder: een raamwerk dat je één keer beschrijft en overal inzet. De architectuur van Hopfield maakt dat waar:
Computertoepassingen Een gewichtenmatrix en een updateregel. Geen GPU nodig.
Internettoepassingen Inhoudsadresseerbaar geheugen voor zoeken op gelijkenis, aanbevelingen en ontdubbeling.
Robotica Gegarandeerde convergentie voor realtime regellussen. Bewegingspatronen worden als attractoren opgeslagen en zelfs bij ruizige sensorinvoer teruggehaald.
Embedded systemen Binaire Hopfield-netwerken draaien op microcontrollers met uitsluitend gehele-getalrekenkunde.
Elektronische schakelingen Symmetrische gewichten vertalen zich naar resistieve netwerken. Intelligentie die rechtstreeks in silicium is gebouwd.
De weg vooruit
Het transformertijdperk gaf ons buitengewone taalmachines. Maar het front verschuift naar de fysieke wereld: robots, sensoren, actuatoren en beslissingen in realtime. Dat vraagt om architecturen die stabiel, efficiënt, interpreteerbaar en inzetbaar zijn op hardware die aan de rand (edge) ook echt bestaat.
Het bewijs uit 2020 dat transformer-attentie is een moderne Hopfield-updateregel, was meer dan een wiskundige curiositeit: het liet zien dat we al die tijd Hopfield-netwerken hebben gebruikt, verpakt in een raamwerk dat hun ware aard aan het zicht onttrok. Het NeurIPS-werk uit 2025, waaruit blijkt dat verborgen Hopfield-toestanden transformerproblemen zoals rank collapse oplossen, wijst op de volgende stap: transformers niet langer bijlappen met inzichten van Hopfield, maar rechtstreeks bouwen op het Hopfield-paradigma zelf.
John Hopfield wees ons de weg in 1982. Donald Hebb legde de biologische fundamenten in 1949. De onderzoeksgemeenschap komt er nu bij elkaar op uit.
Het is tijd om over te stappen.
Bronnen
- Hopfield, J.J. (1982). "Neural networks and physical systems with emergent collective computational abilities." PNAS, 79(8), 2554–2558.
- Hebb, D.O. (1949). The Organization of BehaviorWiley.
- Ramsauer, H. et al. (2020). "Hopfield Networks is All You Need." ICLR 2021. arXiv:2008.02217
- Krotov, D. & Hopfield, J.J. (2016). "Dense Associative Memory for Pattern Recognition." NeurIPS.
- Storkey, A. (1997). "Increasing the capacity of a Hopfield network without sacrificing functionality." ICANN.
- Hoover, B., Krotov, D. et al. (2023). "Energy Transformer." NeurIPS 2023. arXiv:2302.07253
- Masumura, T. & Taki, M. (2025). "On the Role of Hidden States of Modern Hopfield Network in Transformer." NeurIPS 2025. arXiv:2511.20698
- Alonso, N. & Krichmar, J. (2024). "A sparse quantized Hopfield network for online-continual memory." Nature Communications, 15, 3722. nature.com
- Hu, J.Y. et al. (2024). "Outlier-Efficient Hopfield Layers for Large Transformer-Based Models." arXiv:2404.03828
- Hu, J.Y. et al. (2026). "Transformers as Intrinsic Optimizers: Forward Inference through the Energy Principle." arXiv:2511.00907
- Hopfield, J.J. & Tank, D.W. (1985). "'Neural' Computation of Decisions in Optimization Problems." Biological Cybernetics, 52, 141–152.
- Bruck, J. (1990). "On the convergence properties of the Hopfield model." Proceedings of the IEEE.
- Krotov, D. (2025). "Searching for brain-inspired AI algorithms." IBM Research Blog. research.ibm.com
- "Energy-Based Learning and the Evolution of Hopfield Networks." TechRxiv, april 2025. techrxiv.org

